Od telegrafu i komputerów mainframe do idei sieci komputerowej
Telegraf i telefon jako pierwszy „Internet” świata
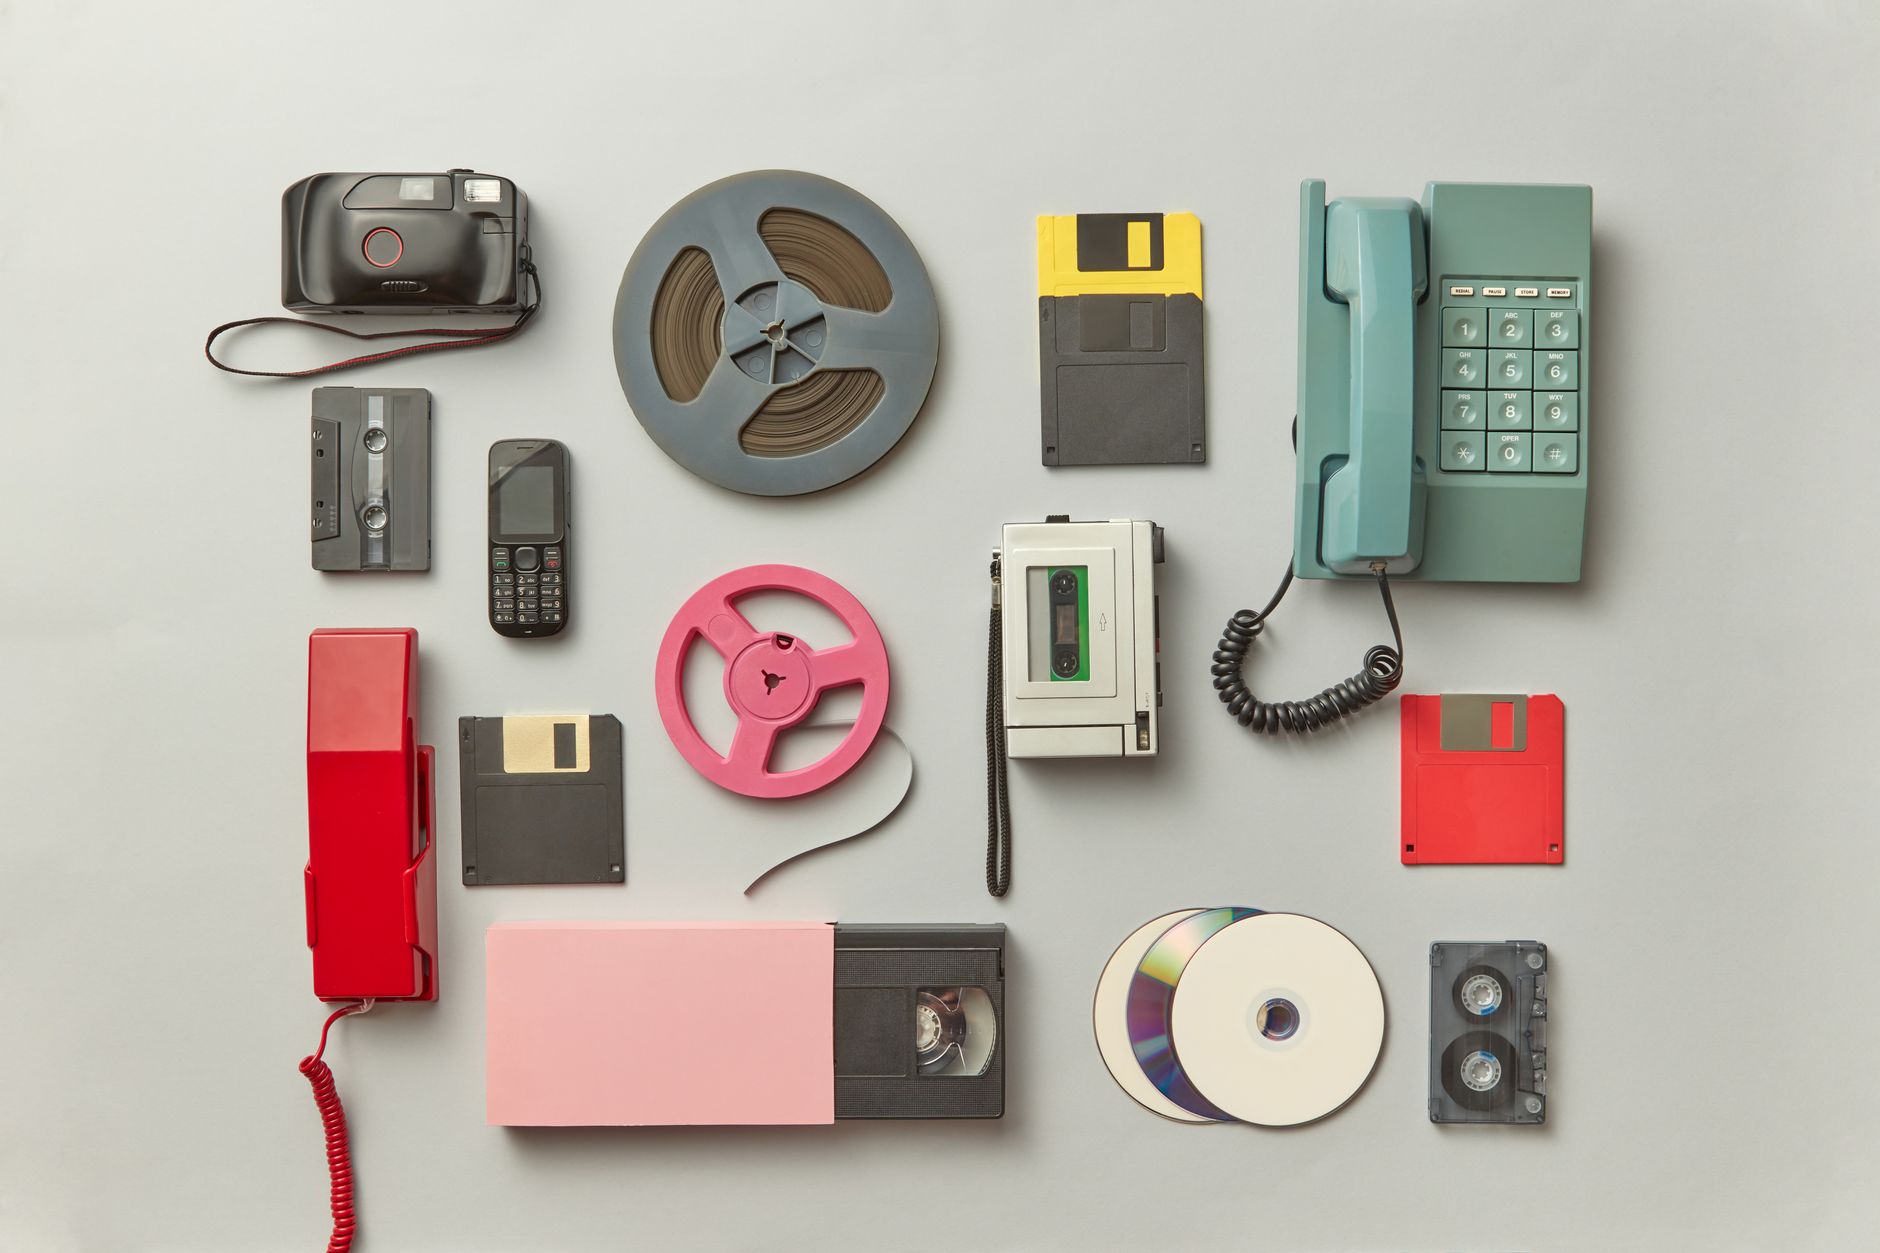
Historia Internetu nie zaczyna się od komputerów, ale od prób przesyłania informacji na odległość szybciej niż człowiek na koniu. Telegraf elektryczny z XIX wieku pozwolił na wysyłanie krótkich komunikatów w formie impulsów elektrycznych. Informacja została oderwana od fizycznego nośnika – to pierwszy krok w stronę świata cyfrowego.
Sieci telegraficzne przypominały bardzo prymitywną wersję współczesnych sieci: istniały węzły (stacje telegraficzne), istniała „adresacja” (oznaczenia stacji, do których kierowano wiadomości), istniała też forma protokołu (kod Morse’a i reguły nadawania). Te systemy były jednak oparte na komutacji łączy: zestawiano konkretne fizyczne połączenie między nadawcą a odbiorcą lub korzystano z serii przekaźników, które ręcznie przełączały sygnał.
Pojawienie się telefonu pod koniec XIX wieku jeszcze mocniej utrwaliło paradygmat komutacji łączy. W sieci telefonicznej każde połączenie wymagało zarezerwowania konkretnego kanału na czas rozmowy. To rozwiązanie doskonale nadawało się do ciągłej transmisji głosu, ale było mało elastyczne i słabo wykorzystywało zasoby. Łącze pozostawało „zajęte”, nawet gdy rozmówcy milczeli.
Mainframe’y, terminale i potrzeba zdalnego dostępu
Komputery pierwszych generacji były ogromnymi maszynami zajmującymi całe pomieszczenia. Kosztowały fortunę, więc naturalnym rozwiązaniem była koncentracja mocy obliczeniowej w jednym miejscu – tak powstały systemy mainframe. Użytkownicy nie mieli własnych komputerów, korzystali z terminali podłączonych do centralnej maszyny.
Terminale były początkowo wyłącznie urządzeniami wejścia/wyjścia – klawiatura i ekran (lub jeszcze wcześniej dalekopis), bez lokalnej mocy obliczeniowej. Jeśli firma lub uniwersytet miał kilka budynków, pojawiał się problem: jak zapewnić dostęp do tego samego mainframe’a użytkownikom w różnych lokalizacjach? W tym momencie zaczyna się myślenie sieciowe.
Równolegle rozwijała się idea time-sharingu, czyli współdzielenia jednego dużego komputera przez wielu użytkowników, którzy logują się zdalnie. Zamiast uruchamiać programy wsadowe (paczki zadań) i czekać godzinami na wydruk, użytkownik mógł wchodzić w interakcję z systemem w czasie quasi-rzeczywistym. Time-sharing był bezpośrednim przodkiem pracy w sieci – wymuszał istnienie protokołów zdalnej komunikacji, uwierzytelniania i zarządzania zasobami.
Wizjonerzy: Bush, Licklider i koncepcja globalnej sieci
Na długo przed ARPANET-em pojawiły się koncepcje intelektualne, które wyprzedzały epokę. Vannevar Bush w 1945 roku opisał ideę memexu – hipotetycznego urządzenia do przechowywania i łączenia dokumentów w sposób kojarzeniowy, przypominający dzisiejsze hiperłącza. Choć opierał się bardziej na mikrofilmach niż elektronice, sama idea nawigacji „po skojarzeniach” była zalążkiem hipertekstu.
J.C.R. Licklider, psycholog i informatyk, w latach 60. rozwijał wizję „intergalactic computer network” – sieci komputerów, w której ludzie i maszyny współdziałają, wymieniając informacje ponad granicami instytucji i państw. Licklider przewidywał powstanie globalnej infrastruktury, w której dostęp do informacji stanie się powszechny. To jego idee mocno wpłynęły na późniejszych twórców ARPANET-u.
Te wczesne koncepcje łączyły się z doświadczeniami z time-sharingiem. Skoro wielu użytkowników może dzielić jeden komputer, to dlaczego wiele komputerów nie miałoby dzielić się zasobami wzajemnie? Z tak postawionego pytania naturalnie rodzi się pojęcie sieci komputerowej, która nie jest tylko przedłużeniem kabli terminalowych, lecz zupełnie nową warstwą infrastruktury.
Od komutacji łączy do komutacji pakietów
Kluczowy przełom między światem telegrafu/telefonu a Internetem to przejście z komutacji łączy na komutację pakietów. W tradycyjnej sieci telefonicznej, gdy dzwonisz, centrala zestawia dedykowane łącze. Jest ono zajęte tylko dla ciebie aż do zakończenia rozmowy. Takie podejście jest wygodne dla głosu, ale fatalne dla ruchu komputerowego, który jest bardzo „szarpany” – chwile intensywnej transmisji przeplatają się z pauzami.
Komutacja pakietów, rozwijana m.in. przez Paula Barana i Donalda Daviesa, zakłada dzielenie danych na małe pakiety, z których każdy może wędrować inną trasą przez sieć. Sieć nie rezerwuje całego łącza dla jednego połączenia – pakiety wielu użytkowników współdzielą te same zasoby. To radykalnie podnosi efektywność i odporność infrastruktury.
Dla zrozumienia przewagi komutacji pakietów warto zwrócić uwagę na trzy cechy:
- Elastyczność trasy: pakiety mogą być przekierowywane innymi drogami, gdy jakiś fragment sieci zawiedzie.
- Podział zasobów: wiele strumieni danych może wykorzystywać to samo łącze, zwiększając przepustowość całego systemu.
- Brak stałego kanału: połączenie nie wymaga dedykowanego toru, co obniża koszty i ułatwia skalowanie.
Bez przyjęcia komutacji pakietów Internet w dzisiejszej formie nie mógłby powstać – tradycyjna struktura telekomunikacyjna nie udźwignęłaby niestabilnego, ogromnie zróżnicowanego ruchu, który generują miliardy urządzeń.
ARPANET – zalążek Internetu i eksperyment z komutacją pakietów
ARPA i zimna wojna jako katalizator innowacji
Agencja ARPA (później DARPA) powstała w USA jako reakcja na wystrzelenie Sputnika przez ZSRR. Celem było przyspieszenie badań naukowych i technologicznych, które miały znaczenie strategiczne. Jednym z problemów, z którymi mierzyło się wojsko i nauka, była odporność komunikacji na ewentualne ataki nuklearne oraz efektywne współdzielenie drogich zasobów komputerowych między ośrodkami badawczymi.
ARPA rozpoczęła finansowanie projektów związanych z time-sharingiem i sieciami komputerowymi. W tym środowisku dojrzewał pomysł stworzenia sieci, która połączy komputery rozproszone po uczelniach i laboratoriach, umożliwiając im wymianę danych i zdalny dostęp do zasobów. Tak narodził się ARPANET – pierwsza duża sieć komutacji pakietów.
Pierwsze węzły i historyczna transmisja UCLA–Stanford
W 1969 roku do ARPANET-u podłączono pierwsze cztery węzły: UCLA, Stanford Research Institute, UC Santa Barbara oraz University of Utah. Węzły te komunikowały się za pośrednictwem specjalnych urządzeń zwanych IMP-ami (Interface Message Processors), które pełniły funkcję dzisiejszych routerów.
Legenda głosi, że pierwszą wiadomością wysłaną przez ARPANET miało być słowo „LOGIN”. Próba połączenia między UCLA a Stanfordem zakończyła się częściowym sukcesem: system zawiesił się po przesłaniu liter „L” i „O”. Mimo tej awarii przełom był dokonany – dwa odległe komputery mainframe, używające różnych systemów, wymieniły dane przy użyciu nowego rodzaju sieci.
W kolejnych latach do ARPANET-u dołączały następne ośrodki naukowe. Sieć zaczęła pełnić rolę infrastruktury eksperymentalnej, na której testowano kolejne protokoły i aplikacje. Równolegle dojrzewała kultura współpracy między zespołami z różnych uczelni – fundament przyszłej otwartej kultury internetowej.
Wczesne protokoły i aplikacje: NCP, e-mail, zdalny dostęp
Pierwszym szeroko stosowanym protokołem w ARPANET był NCP (Network Control Program), który zapewniał podstawową obsługę połączeń pomiędzy hostami. Na jego bazie powstawały konkretne aplikacje, które szybko pokazały potencjał sieci.
Jedną z pierwszych „killer applications” okazał się e-mail. Zaczęło się od prostych programów do przesyłania wiadomości między użytkownikami tej samej maszyny, ale bardzo szybko rozszerzono je na komunikację między komputerami w sieci. E-mail natychmiast uprościł współpracę naukowców, zastępując wiele tradycyjnej korespondencji.
Oprócz poczty rozwijały się narzędzia do zdalnego logowania (remote login) i przesyłania plików. Możliwość zalogowania się na odległy komputer i uruchomienia na nim programów drastycznie obniżyła barierę dostępu do mocy obliczeniowej i oprogramowania. Dla ówczesnych użytkowników był to skok porównywalny z przejściem z poczty tradycyjnej na komunikatory.
Kultura RFC i otwarty rozwój standardów
Wokół ARPANET-u wykształciła się specyficzna kultura sieciowa, oparta na współdzieleniu wiedzy i otwartej dyskusji. Kluczową rolę odegrały dokumenty Request for Comments (RFC), które początkowo były roboczymi notatkami i propozycjami rozwiązań technicznych, przesyłanymi pocztą elektroniczną między badaczami.
RFC szybko stały się głównym mechanizmem tworzenia standardów Internetu. Każdy mógł zgłosić propozycję, podlegała ona krytyce i rozwijaniu przez społeczność. Formalizm był początkowo niewielki, ważniejsze były pragmatyzm i działające implementacje. Ta kultura „rough consensus and running code” przetrwała do dziś i stanowi przeciwwagę dla ciężkich, zamkniętych procesów standaryzacji w innych dziedzinach telekomunikacji.
W praktyce oznaczało to, że Internet od samego początku rósł jako sieć oparta na otwartych standardach. Zamiast chronić specyfikacje za paywallem, twórcy udostępniali je publicznie, umożliwiając niezależnym zespołom implementację. To otwartość sprawiła, że technologie internetowe mogły być szybko adoptowane na całym świecie.
Od ARPANET do Internetu – TCP/IP, standardy i integracja sieci
Problem internetworkingu: jak połączyć różne sieci?
ARPANET był tylko jedną z wielu sieci eksperymentalnych. Pojawiały się kolejne: sieci satelitarne, radiowe, lokalne sieci komputerowe (LAN). Każda używała innych protokołów i mechanizmów transmisji. Powstał kluczowy problem: jak połączyć te sieci w jedną logiczną całość, nie zmuszając wszystkich do zmiany technologii?
To wyzwanie nazwano internetworkingiem – łączeniem sieci w „sieć sieci”. Rozwiązania wymagały nowej warstwy protokołu, która byłaby niezależna od sposobu transmisji na poziomie fizycznym (światłowód, radio, kabel miedziany) i od specyfiki poszczególnych sieci. Potrzebny był wspólny język na wyższym poziomie abstrakcji.
TCP/IP – projekt Cerfa i Kahna oraz zwycięstwo pakietów
Vint Cerf i Bob Kahn zaproponowali zestaw protokołów, który miał rozwiązać problem internetworkingu. Tak powstało TCP/IP – kombinacja protokołu transmisji (TCP) i protokołu internetowego (IP). Główne założenia były zaskakująco proste, ale do dziś okazały się niezwykle trwałe:
- Warstwowość: TCP/IP działa ponad różnymi technologiami transmisji, nie wymagając od aplikacji wiedzy o fizycznym medium.
- Bezstanowość sieci: sieć nie przechowuje informacji o połączeniach użytkowników, przechowuje ją głównie końcowy host; to upraszcza i uodparnia infrastrukturę.
- Best effort: IP nie gwarantuje dostarczenia pakietu, ale dostarcza prosty, skalowalny mechanizm routingu; niezawodność zapewnia warstwa wyżej (np. TCP).
Model pakietowy „wygrał”, bo lepiej skalował się wraz z rosnącą liczbą sieci i użytkowników. TCP/IP okazał się wystarczająco prosty, by dało się go zaimplementować w ówczesnych systemach, a zarazem wystarczająco elastyczny, by przetrwać kolejne dekady rewolucji sprzętowych.
Rok 1983 – symboliczny start Internetu
1 stycznia 1983 roku ARPANET oficjalnie przełączył się z NCP na TCP/IP. Ten moment często uznaje się za symboliczny „start” Internetu. Od tego dnia różne sieci mogły łączyć się w jedną sieć sieci, korzystając z wspólnego protokołu IP.
Przejście nie było proste – wymagało modyfikacji oprogramowania na wielu hostach, testowania kompatybilności i migracji działających aplikacji. Jednak korzyści były oczywiste: ARPANET zyskiwał możliwość komunikacji z innymi sieciami, które przyjęły TCP/IP, a nie tylko z własnymi węzłami.
W kolejnych latach pojęcie Internetu zaczęło wypierać nazwę ARPANET. Sieć przestała być wyłącznie przedsięwzięciem wojskowo-akademickim, coraz mocniej wchodząc w świat cywilny i komercyjny. Jednak nadal dominowały instytucje naukowe i badawcze, a dostęp był przywilejem, nie standardem.
IETF, RFC i utrwalanie otwartych standardów
Aby rozwijać TCP/IP i inne protokoły, potrzebna była zorganizowana, ale elastyczna struktura. Tak powstało IETF (Internet Engineering Task Force) – społeczność inżynierów odpowiedzialna za praktyczny rozwój standardów internetowych. IETF nie jest klasyczną organizacją z hierarchią biurokratyczną, raczej luźnym zbiorem grup roboczych, które pracują nad konkretnymi tematami.
Model pracy IETF pozostaje spójny z duchem pierwszych RFC: otwarte spotkania, publiczne listy dyskusyjne, decyzje podejmowane na podstawie argumentów technicznych i działających implementacji, a nie politycznych ustaleń. Standardy Internetu są publikowane właśnie jako RFC, co gwarantuje każdemu dostęp do specyfikacji HTTP, SMTP, DNS czy protokołów routingu bez opłat licencyjnych i barier formalnych.
Taka struktura ma praktyczne konsekwencje. Jeśli operator sieci, twórca systemu operacyjnego lub startup pracujący nad nową usługą widzi problem w istniejących protokołach, może przygotować propozycję zmian, wdrożyć prototyp i skonfrontować go z innymi implementacjami. Gdy rozwiązanie się sprawdzi, stosunkowo szybko dojrzewa do roli standardu, a następnie przenika do sprzętu, oprogramowania i produktów konsumenckich.
Otwarte standardy z IETF utrudniają tworzenie zamkniętych „silosów” komunikacyjnych, które nie rozmawiają ze sobą. Jeśli dwie firmy implementują ten sam RFC, ich systemy mogą się ze sobą komunikować, nawet jeśli są bezpośrednimi konkurentami. To jeden z powodów, dla których e-mail czy WWW działają globalnie, niezależnie od tego, z jakiego dostawcy usług, przeglądarki czy systemu operacyjnego korzysta użytkownik.
Internet wyrósł więc nie tylko z innowacji sprzętowych i programistycznych, ale też z konkretnego modelu współpracy: minimalnej biurokracji, jawnych dyskusji, dostępnych publicznie dokumentów i nastawienia na praktyczne, działające rozwiązania. Ten wzorzec, ukształtowany jeszcze w czasach ARPANET-u i pierwszych RFC, nadal decyduje o tempie rozwoju sieci, z której dziś korzystają miliardy ludzi na całym świecie.
Lata 80.: rozbudowa sieci akademickich, DNS i pierwsze protokoły użytkowe
Od ARPANET-u do NSFNET i sieci akademickich
W latach 80. ciężar rozwoju Internetu zaczął przesuwać się z agencji wojskowych na instytucje cywilne. Kluczową rolę odegrała amerykańska National Science Foundation (NSF), która sfinansowała powstanie NSFNET – sieci szkieletowej łączącej superkomputery i ośrodki badawcze w USA. NSFNET od początku wykorzystywał TCP/IP i pełnił rolę kręgosłupa dla rosnącej liczby sieci kampusowych.
Model był prosty: lokalna sieć uczelni łączyła się jednym lub kilkoma łączami z siecią krajową, a ta – poprzez węzły wymiany – z innymi sieciami akademickimi i ARPANET-em. Dzięki temu coraz więcej studentów i badaczy mogło korzystać z poczty elektronicznej, zdalnego logowania czy transferu plików, nie zdając sobie często sprawy, że „pod spodem” działa zestaw złożonych protokołów.
Podobne procesy zachodziły w Europie i innych częściach świata. Powstawały krajowe sieci badawcze (np. EARN, później europejski RIPE NCC jako struktura koordynacyjna), a uczelnie zaczęły intensywnie inwestować w lokalne sieci Ethernet. Internet stawał się coraz bardziej globalny, choć wciąż zdominowany przez środowisko akademickie.
Problem nazw: skąd wziął się DNS
Rosnąca liczba hostów ujawniła poważny problem: adresy IP są trudne do zapamiętania, a proste pliki mapujące nazwy na adresy szybko przestały być skalowalne. Na początku używano ręcznie dystrybuowanego pliku HOSTS.TXT, aktualizowanego przez centralny ośrodek. Przy kilkudziesięciu maszynach było to uciążliwe; przy setkach – nie do utrzymania.
Rozwiązaniem był DNS (Domain Name System), zaprojektowany przez Pala Mockapetrisa. DNS wprowadził hierarchiczną, rozproszoną bazę nazw domenowych. Zamiast jednego pliku pojawiły się:
- strefy (zones) – fragmenty przestrzeni nazw, za które odpowiadają konkretne serwery,
- rekursywne serwery DNS – odciążające klienta z konieczności chodzenia po całej hierarchii,
- system delegacji – dzięki któremu właściciel domeny zarządza własnym poddrzewem bez pytania centrum o zgodę na każdą zmianę.
Na poziomie użytkownika oznaczało to przejście z adresów typu 26.0.0.73 na przyjazne nazwy pokroju mit.edu czy stanford.edu. Dla operatorów sieci DNS stał się krytyczną usługą infrastrukturalną – bez niego większość aplikacji po prostu nie działa.
Pierwsze protokoły użytkowe: FTP, Telnet, SMTP
Na fundamencie TCP/IP i DNS szybko rozwijały się kolejne protokoły aplikacyjne. W latach 80. dominowały narzędzia tekstowe, obsługiwane z poziomu terminala, ale już wtedy widać było zalążki usług, które później trafiły „pod maskę” graficznych interfejsów:
- FTP (File Transfer Protocol) – podstawowy mechanizm przesyłania plików. Umożliwiał zarówno publikację danych (anonimowe serwery FTP), jak i wymianę wyników badań między zespołami. Dla wielu naukowców „Internet” oznaczał po prostu dostęp do odległego archiwum FTP.
- Telnet – protokół zdalnego logowania oparty na połączeniu znakowym. Użytkownik siedzący w jednym mieście mógł pracować jakby fizycznie znajdował się przy terminalu głównego komputera uczelni po drugiej stronie kontynentu. Telnet nie szyfrował ruchu, ale w tamtej epoce dominowało założenie zaufania wewnątrz sieci akademickich.
- SMTP (Simple Mail Transfer Protocol) – podstawa globalnej wymiany poczty. W połączeniu z prostymi klientami tekstowymi (np. sendmail, pine, elm) stworzył infrastrukturę, która w wersji rozszerzonej (MIME) i zabezpieczonej (TLS) istnieje praktycznie do dziś.
Na poziomie organizacji pojawiało się nowego rodzaju zjawisko: komunikacja asynchroniczna w skali międzynarodowej bez konieczności korzystania z poczty tradycyjnej czy drogich połączeń telefonicznych. E-mail zaczął wypierać faks, a współpraca w projektach badawczych przyspieszyła o całe rzędy wielkości.
Usenet, grupy dyskusyjne i wczesne społeczności online
Jeszcze przed upowszechnieniem Internetu w dzisiejszej formie pojawił się Usenet – rozproszony system grup dyskusyjnych. Nie był formalnie częścią Internetu, ale szybko został z nim zintegrowany, a wymiana postów zaczęła odbywać się także poprzez łącza TCP/IP.
Usenet wprowadził strukturę tematycznych grup (np. comp.* dla informatyki, sci.* dla nauk ścisłych, rec.* dla rozrywki), w których użytkownicy mogli publikować wiadomości widoczne dla całej społeczności. Był to prototyp późniejszych forów, list mailingowych i mediów społecznościowych. Dyskusje toczyły się asynchronicznie, w wątkach, często z udziałem osób z różnych kontynentów.
W praktyce oznaczało to narodziny pierwszych, globalnych społeczności tematycznych. Programiści wymieniali się kodem i poradami, naukowcy dyskutowali wyniki badań, a studenci organizowali wspólne projekty i życie towarzyskie. Kultura otwartej dyskusji, pseudonimów i netykiety kształtowała się na Usenecie znacznie wcześniej niż pojawiły się takie serwisy jak Facebook czy Twitter.
Narodziny World Wide Web i rewolucja lat 90.
Tim Berners-Lee i idea hipertekstu na TCP/IP
Pod koniec lat 80. inżynier CERN-u, Tim Berners-Lee, szukał sposobu uporządkowania dokumentów i notatek naukowców pracujących nad fizyką wysokich energii. Problem był prosty: ogromna liczba raportów, specyfikacji i artykułów, rozproszonych po różnych systemach i serwerach. Rozwiązaniem miało być połączenie hipertekstu z Internetem.
Berners-Lee zaproponował zestaw trzech kluczowych elementów:
- HTML (HyperText Markup Language) – prosty język znaczników do tworzenia dokumentów z odnośnikami, nagłówkami i strukturą logiczną,
- HTTP (HyperText Transfer Protocol) – lekki protokół komunikacji klient–serwer, działający nad TCP,
- URL (Uniform Resource Locator) – jednolity sposób adresowania zasobów w sieci.
Pierwsza przeglądarka i serwer WWW powstały na komputerach NeXT w CERN-ie. Początkowo były to narzędzia wewnętrzne, ale w 1991 roku specyfikacje i kod udostępniono publicznie, bez opłat licencyjnych. Ten gest – kompatybilny z duchem otwartych standardów Internetu – umożliwił lawinowy rozwój nowych implementacji przeglądarek i serwerów.
NCSA Mosaic, Netscape i „eksplozja” sieci WWW
Punktem zwrotnym była praca zespołu z NCSA (National Center for Supercomputing Applications), który stworzył przeglądarkę Mosaic. Działała na popularnych systemach (Unix, Windows, Mac), obsługiwała grafikę osadzoną w tekście i była stosunkowo łatwa w instalacji. Dla wielu użytkowników było to pierwsze doświadczenie z Internetem w postaci kolorowych stron, odnośników i obrazków.
Część zespołu Mosaic założyła później firmę Netscape i wydała przeglądarkę Netscape Navigator, która szybko zdobyła dominującą pozycję na rynku. Netscape wprowadzał kolejne rozszerzenia (np. cookies, ramki, wczesne skrypty), często wyprzedzając formalne standardy. Konkurencja z Microsoftem, który odpowiedział przeglądarką Internet Explorer, zapoczątkowała tzw. wojny przeglądarek.
W tym okresie nastąpił gwałtowny wzrost liczby stron WWW. Uczelnie i instytucje publiczne tworzyły witryny informacyjne, firmy zaczęły dostrzegać potencjał marketingowy, a prywatni użytkownicy tworzyli pierwsze strony domowe. Dla przeciętnego internauty Internet przestał być zestawem tekstowych narzędzi; stał się „przeglądarką”, w której można klikać linki i „surfować” po stronach.
Standaryzacja: od HTML 2.0 do W3C
Szybki rozwój WWW wymusił uporządkowanie specyfikacji. W połowie lat 90. powstało W3C (World Wide Web Consortium), skupiające naukowców, firmy i organizacje zainteresowane rozwojem technologii webowych. Jego celem była koordynacja standardów takich jak:
- HTML – ewolucja od prostego formatu tekstowego do bogatszego języka opisu dokumentów,
- CSS (Cascading Style Sheets) – oddzielenie warstwy prezentacji od struktury dokumentu,
- XML i później DOM, JavaScript i standardy skryptowe – umożliwiające tworzenie bardziej interaktywnych stron.
Powstanie W3C ograniczyło chaos wywołany prywatnymi rozszerzeniami przeglądarek. Nadal istniały różnice implementacyjne, ale istniał też punkt odniesienia w postaci otwartych specyfikacji. Dzięki temu deweloperzy mogli projektować strony, które z rozsądną dokładnością działały w różnych przeglądarkach i systemach.
Pierwsze wyszukiwarki: od katalogów do indeksowania całej sieci
Gwałtowny przyrost liczby stron WWW sprawił, że potrzebne były narzędzia wyszukiwania. Pierwsze podejścia miały formę ręcznie tworzonych katalogów (np. Yahoo! Directory), w których redaktorzy kategoryzowali strony według tematów. Szybko okazało się jednak, że model ręcznej selekcji nie skaluje się wraz z tempem przyrostu treści.
Pojawiły się więc automatyczne wyszukiwarki, wykorzystujące tzw. roboty lub pająki (crawlers) do przeglądania stron i budowania indeksów. Ważne były dwa elementy:
- algorytm indeksowania – określający, jak reprezentować treść stron w bazie danych wyszukiwarki,
- metoda rankingowa – decydująca, które wyniki pojawią się wyżej na liście.
W drugiej połowie lat 90. pojawiły się wyszukiwarki takie jak AltaVista czy Lycos, a pod koniec dekady – Google, które zastosowało analizę linków (PageRank) jako wskaźnik „reputacji” strony. To przeniosło ciężar z katalogów kuratorowanych ręcznie na algorytmy, które mogły objąć rosnący w eksponencjalnym tempie zbiór dokumentów WWW.
Bańka dotcomów i dojrzewanie gospodarki internetowej
Komercjalizacja Internetu i zniesienie ograniczeń NSFNET
Do połowy lat 90. znaczna część infrastruktury Internetu była finansowana publicznie, a korzystanie z niej do celów komercyjnych było formalnie ograniczone. Przełom nastąpił, gdy NSFNET wycofał się z roli sieci szkieletowej, a jego funkcję przejęły komercyjne sieci operatorów. Sieć otworzyła się na biznes w pełnym wymiarze.
Powstały masowo dostawcy usług internetowych (ISP), oferujący dostęp dial-up (łącza telefoniczne z modemem) gospodarstwom domowym i małym firmom. Pojawiły się pierwsze portale, sklepy internetowe i serwisy informacyjne. Model ekonomiczny był jednak niejasny: wielu przedsiębiorców zakładało, że sama obecność „w Internecie” w przyszłości przyniesie zyski, nawet jeśli początkowo trudno je było wykazać.
E-commerce, portale i nowe modele przychodu
W drugiej połowie lat 90. rozwijały się podstawowe modele biznesowe w sieci:
- handel elektroniczny (e-commerce) – sklepy internetowe sprzedające książki, elektronikę czy bilety (np. wczesny Amazon) pokazywały, że logistyka i płatności online mogą tworzyć realny biznes,
- portale – serwisy typu „brama do Internetu” (Yahoo!, Onet, Wirtualna Polska) łączyły wiadomości, katalog stron, pocztę i komunikatory, monetyzując ruch poprzez reklamę,
- płatne treści i subskrypcje – część mediów eksperymentowała z paywallem, ale ograniczenia techniczne i nawyki użytkowników utrudniały wówczas szeroką adopcję.
Firmy internetowe intensywnie inwestowały w rozpoznawalność marki, często kosztem krótkoterminowej rentowności. Liczyła się liczba użytkowników i ruch na stronie, zakładano bowiem, że w przyszłości da się go łatwo zmonetyzować. To nastawienie stało się jednym z paliw nadmuchujących bańkę dotcomów.
Kult „.com” i pęknięcie bańki
Końcówka lat 90. to okres euforii inwestycyjnej związanej z firmami z końcówką .com. Kapitał napływał do startupów o luźno zdefiniowanych modelach biznesowych, często wyłącznie na podstawie obietnicy „zrewolucjonizowania branży dzięki Internetowi”. Wyceny spółek rosły mimo braku zysków, a w wielu przypadkach nawet przy bardzo ograniczonych przychodach.
W efekcie powstał klasyczny scenariusz bańki spekulacyjnej: łatwy dostęp do kapitału, presja na szybki wzrost „za wszelką cenę” i zacieranie granicy między realnym potencjałem biznesowym a marketingową narracją. Kiedy okazało się, że przychody nie nadążają za wycenami, a wiele spółek spala gotówkę bez jasnej ścieżki do zyskowności, nastroje na rynkach odwróciły się. Na przełomie lat 2000–2001 indeksy giełdowe związane z technologią i Internetem załamały się, a setki firm zniknęły lub zostały przejęte za ułamek wcześniejszej wartości.
Pęknięcie bańki dotcomów wyczyściło rynek z wielu projektów opartych głównie na haśle „Internet zmieni wszystko”, bez dopracowanej logistyki, technologii i modelu przychodu. Przetrwały te przedsiębiorstwa, które potrafiły wykazać realną wartość dla użytkownika, optymalizować koszty i skalować operacje. Amazon zamiast koncentrować się na krótkoterminowym zysku, rozwijał infrastrukturę logistyczną i technologie back-endowe; inne firmy przestawiały się z agresywnej akwizycji użytkowników na retencję i poprawę unit economics.
Dla całej gospodarki był to bolesny, ale pouczający test. Inwestorzy zaczęli zwracać większą uwagę na fundamenty finansowe, a nie tylko „efekt sieciowy” deklarowany w prezentacjach. Regulacje rynku kapitałowego i standardy raportowania spółek technologicznych zostały zaostrzone. Jednocześnie infrastruktura zbudowana w czasach bańki – łącza, serwerownie, doświadczenie inżynierów – nie zniknęła. Stała się bazą pod stabilniejszą fazę rozwoju usług internetowych w kolejnych latach.
W dłuższej perspektywie bańka dotcomów pełniła rolę filtra. Oddzieliła wizje, które wymagały jeszcze dekady dojrzewania technologii i nawyków użytkowników, od rozwiązań gotowych do masowej adopcji. Projekty wyprzedzające swój czas – np. zbyt ambitne platformy wideo czy mobilne – upadły, ale idee, które wniosły, wróciły później w dojrzałej postaci serwisów streamingowych, aplikacji mobilnych czy platform social media.
Od kryzysu do dojrzałości: firmy internetowe jako „zwykły” biznes
Po 2001 roku firmy działające w sieci zaczęły funkcjonować coraz bardziej jak klasyczne przedsiębiorstwa. Zamiast jedynie „być online”, trzeba było udowodnić, że każdy element łańcucha wartości – od pozyskania klienta, przez obsługę zamówienia, po wsparcie posprzedażowe – jest zoptymalizowany. Internet stał się kanałem operacyjnym, a nie jedynie obietnicą przyszłych zysków.
Zmieniło się podejście do inwestycji w infrastrukturę. Operatorzy telekomunikacyjni i dostawcy usług hostingowych budowali centra danych z myślą o długoterminowej efektywności, a nie szybkim „sprzedaniu historii” inwestorom. Z drugiej strony, rozwój technologii serwerowych i oprogramowania open source (Linux, Apache, bazy danych SQL) znacznie obniżył próg wejścia dla nowych graczy. Jeśli ktoś potrafił dobrze zaprojektować produkt i model przychodu, nie potrzebował już tak dużych nakładów kapitałowych jak pionierzy z końca lat 90.
Coraz większe znaczenie zyskiwały też dane. Firmy uczyły się mierzyć zachowania użytkowników – od czasu spędzanego na stronie po skuteczność kampanii reklamowych – i na tej podstawie korygować ofertę. Jeśli wcześniej liczyła się głównie liczba odsłon, to po okresie bańki coraz częściej analizowano jakość ruchu, konwersję i lojalność. Ten zwrot w stronę analityki przygotował grunt pod późniejsze modele reklamy kontekstowej i platformy, które dziś kojarzą się z „gospodarką uwagi”.
Naturalnym skutkiem tego przesunięcia było też inne postrzeganie ryzyka technologicznego. Przestano zakładać, że „technologia sama się sprzeda”. Projekty musiały przejść przez filtr testów A/B, pilotaży z ograniczoną grupą użytkowników i szczegółowych prognoz finansowych. Jeśli nowa usługa nie poprawiała wskaźników – kosztu pozyskania klienta, średniej wartości koszyka, odsetka rezygnacji – była modyfikowana lub porzucana. Internet stał się przestrzenią intensywnych eksperymentów, ale opartych na liczbach, a nie wyłącznie na intuicji założycieli.
Na tym tle wyrosła kolejna generacja firm technologicznych, które łączyły dziedzictwo „starego Internetu” z bardziej dojrzałym podejściem operacyjnym. Serwisy społecznościowe, platformy wideo czy wyszukiwarki reklamowe powstawały już w realiach tańszego sprzętu, szerokopasmowego dostępu i użytkowników przyzwyczajonych do codziennego korzystania z sieci. Mogły od razu projektować usługi z myślą o milionach odbiorców, a nie kilku entuzjastach z uczelnianych laboratoriów. To właśnie one wykorzystały infrastrukturę i doświadczenia przełomu wieków jako trampolinę do epoki social mediów i streamingu.
Dalsza historia Internetu to opowieść o tym, jak dostęp do szybkich łączy, rozwój technologii mobilnych i rosnąca moc centrów danych przekształciły sieć z narzędzia komunikacji i wyszukiwania informacji w środowisko, w którym spędza się znaczną część życia zawodowego i prywatnego. Zmienił się też ciężar innowacji: z warstwy czysto technicznej na projektowanie doświadczeń użytkownika, algorytmów rekomendacyjnych i mechanizmów przyciągania uwagi.
Szerokopasmowy dostęp i infrastruktura dla wideo
W pierwszych latach XXI wieku kluczowe przesunięcie dokonało się w warstwie dostępowej. Modemy telefoniczne ustępowały miejsca stałym łączom: najpierw DSL w sieciach miedzianych, potem Internetowi kablowemu, a w końcu światłowodom do domów (FTTH) i osiedlowym sieciom ethernetowym. Zmieniło to nie tylko komfort przeglądania stron, ale również to, jakiego typu treści można było w ogóle sensownie dostarczać.
Szerokopasmowe łącza wyeliminowały podstawową barierę dla transmisji wideo: brak przepustowości i konieczność „zajmowania linii telefonicznej”. Użytkownik nie musiał już decydować, czy przez najbliższe pół godziny dom będzie miał telefon, czy Internet. Stały dostęp uczynił sieć infrastrukturą tła, stale obecną, a nie usługą uruchamianą „na chwilę”.
Równolegle taniały serwery i pojawiały się wyspecjalizowane centra danych. Firmy zaczęły wykorzystywać content delivery networks (CDN), czyli rozproszone sieci serwerów cache’ujących treści bliżej użytkownika. Bez CDN-ów wideo na żądanie na masową skalę byłoby praktycznie niewykonalne – każdy plik musiałby być serwowany z kilku głównych węzłów, co szybko zabiłoby wydajność. CDN rozkładał obciążenie i skracał drogę, jaką pokonywały pakiety z filmem czy transmisją na żywo.
Nowa infrastruktura powstała w odpowiedzi na bardzo konkretne parametry jakościowe. Utrwaliły się trzy główne wymagania dla usług wideo:
- przepustowość – minimalna, stabilna szybkość łącza, by strumień danych mógł być dekodowany bez przerw,
- opóźnienie (latencja) – szczególnie ważne przy transmisjach na żywo i usługach interaktywnych (konferencje, gry),
- jitter i buforowanie – zmienność opóźnień musiała być maskowana algorytmami buforowania, aby użytkownik nie oglądał „zacinającego się” obrazu.
Dostawcy usług internetowych zaczęli negocjować umowy peeringowe i budować własne sieci szkieletowe z myślą o rosnącym ruchu multimedialnym. Udział wideo w całkowitym ruchu sieciowym rósł, co wymuszało modernizację sprzętu i stopniowe przechodzenie na szybsze standardy – od 100 Mb/s po 10 Gb/s i więcej w punktach wymiany ruchu.
Kompresja, kodeki i adaptacyjne strumieniowanie
Sam dostęp szerokopasmowy nie wystarczyłby, gdyby nie postęp w kompresji wideo. Standardy takie jak MPEG-2, a później MPEG-4/H.264 i H.265/HEVC, pozwoliły znacząco zmniejszyć rozmiar plików przy akceptowalnej jakości obrazu. Technicznie oznaczało to wyrafinowane metody przewidywania kolejnych klatek, eliminację redundancji przestrzennej i czasowej oraz kodowanie tylko „różnic” między ujęciami.
W praktyce każdy krok naprzód w kodekach otwierał nowe możliwości biznesowe. Jeśli ten sam film można było przesłać przy dwa razy mniejszym bitrate, to:
- dla operatora oznaczało to obsłużenie większej liczby widzów na tej samej infrastrukturze,
- dla użytkownika – niższe wymagania względem łącza i mniejsze ryzyko zacinania się obrazu.
Dalszym przełomem było adaptacyjne strumieniowanie (MPEG-DASH, HLS). Widz nie musiał już wybierać jakości filmu ręcznie; odtwarzacz sam dopasowywał bitrate do bieżącej przepustowości łącza. Jeśli obciążenie sieci rosło lub ktoś w domu rozpoczął pobieranie dużego pliku, strumień automatycznie przełączał się na niższą jakość zamiast przerywać odtwarzanie. Z biznesowego punktu widzenia obniżało to poziom frustracji użytkownika i ograniczało liczbę rezygnacji z usługi.
Od plików do strumieni: zmiana paradygmatu konsumpcji
Przed epoką streamingu typowy scenariusz wyglądał następująco: pobranie pliku (często z sieci P2P), lokalne zapisanie go na dysku, a następnie odtworzenie w odizolowanym od sieci odtwarzaczu. Prawa autorskie były słabo egzekwowane, a użytkownik przyzwyczajał się do pełnej kontroli nad kopią pliku.
Streaming odwrócił te założenia. Użytkownik nie otrzymywał już pliku, lecz tymczasowy strumień danych. Dostawca usług zachowywał kontrolę nad treścią – mógł ją w każdej chwili wycofać, zmienić katalog licencji, ograniczyć dostęp do konkretnych regionów. Z punktu widzenia infrastruktury i właścicieli praw autorskich było to rozwiązanie znacznie bardziej przewidywalne i podatne na monetyzację.
Zmieniły się też nawyki odbiorców. Zamiast planować pobrania na noc na wolnym łączu, użytkownicy zaczęli oglądać „od ręki”. To otworzyło drogę do modelu subskrypcyjnego: zamiast płacić za pojedynczy plik, płaci się za stały dostęp do biblioteki, a bariery przełączania między utworami czy filmami prawie znikają. Mechanizm, który sprawdził się w muzyce (np. streaming zamiast plików MP3), naturalnie przeniósł się na wideo.
Platformy wideo i narodziny streamingu masowego
Wraz z rozpowszechnieniem szerokopasmowych łączy pojawiły się platformy, dla których wideo stało się treścią podstawową, a nie dodatkiem do tekstu. Początkowo były to proste serwisy umożliwiające wysyłanie krótkich klipów, ale bardzo szybko nabrały skali globalnych mediów.
Serwisy wideo użytkowników: od amatorskich klipów do profesjonalnych kanałów
Platformy oparte na treściach tworzonych przez użytkowników przyniosły kilka jakościowych zmian. Po pierwsze, bariera wejścia do „nadawania” spadła praktycznie do zera. Wystarczał telefon z aparatem i podstawowe łącze, by zamieszczać materiały, które mogły potencjalnie dotrzeć do milionów odbiorców. Po drugie, pojawił się nowy typ twórcy – niezależny „kanał” budujący bezpośrednią relację z widzami, często bez pośrednictwa tradycyjnych redakcji czy wytwórni.
Model biznesowy takich platform początkowo był nieoczywisty. Skupiano się na jak najszybszym wzroście liczby użytkowników, licząc, że określone formaty reklamy wideo i sponsoringów pozwolą później na monetyzację. Ostatecznie wykrystalizował się układ trójstronny: platforma – reklamodawca – twórca. Platforma dzieliła się przychodami z reklam z twórcami według określonych algorytmów, jednocześnie gromadząc ogromny zbiór danych o zachowaniach odbiorców.
Ten model miał kilka konsekwencji:
- motywował twórców do optymalizacji pod algorytm rekomendacyjny (długość materiału, częstotliwość publikacji, współczynnik utrzymania uwagi),
- przenosił ryzyko na twórców – jeśli algorytm przestawał promować dany typ treści, dochody mogły spaść z miesiąca na miesiąc,
- wzmacniał pozycję platformy jako jedynego pośrednika w relacji z widzem; bez dostępu do danych o odbiorcach twórcy mieli ograniczone możliwości migracji do konkurencyjnych usług.
Przykładowo osoba prowadząca kanał edukacyjny musiała projektować treści w taki sposób, by maksymalizować oglądalność pierwszych minut nagrania, inaczej algorytm uznawał materiał za „mniej angażujący”, co ograniczało jego zasięg. Decyzje techniczne platformy bezpośrednio wpływały więc na format i styl tworzonych materiałów.
Streaming na żądanie a tradycyjna telewizja
Drugi filar rewolucji wideo stanowiły platformy VOD (video on demand), które zaczęły konkurować z klasyczną telewizją. Różnice widoczne były na kilku poziomach:
- model programowy – zamiast ramówki nadawanej o określonej godzinie pojawiła się biblioteka dostępna „od ręki”,
- personalizacja – rekomendacje oparte na historii oglądania zastąpiły jednolity przekaz dla wszystkich,
- model reklamowy – część usług oparła się na subskrypcjach bez reklam, inne łączyły abonament z przerwami reklamowymi o mniejszej intensywności niż tradycyjna telewizja.
Z perspektywy operatorów telewizyjnych wymuszało to trudne decyzje. Albo uruchamiali własne usługi OTT (over-the-top), konkurując po części sami ze sobą, albo ryzykowali utratę młodszej publiczności, dla której oglądanie na żądanie stało się normą. Dodatkowo zmienił się sposób rozliczeń z producentami treści – pojawiły się licencje czasowe, podział według popularności poszczególnych tytułów, a także produkcje własne platform.
Streaming wideo na żądanie szybko zaczął konsumować coraz większą część pasma w sieci. W niektórych regionach udział tego typu ruchu w całkowitym wolumenie danych przekraczał znacząco inne kategorie. W odpowiedzi operatorzy zaczęli rozważać polityki zarządzania ruchem (traffic shaping), priorytetyzację określonych protokołów oraz cache’owanie popularnych treści na poziomie lokalnych węzłów. Dyskusja o neutralności sieci nabrała nowej temperatury – pytanie, czy operator może uprzywilejować własną usługę wideo kosztem konkurencyjnych platform, przestało być czysto teoretyczne.
Mobilny Internet i przeniesienie streamingu do kieszeni
Kolejnym przełomem było połączenie możliwości transmisji danych w sieciach komórkowych z rosnącą mocą obliczeniową smartfonów. Gdy 3G, a potem 4G/LTE osiągnęły szeroką dostępność, korzystanie z Internetu przestało być aktywnością „przy biurku”.
Smartfon jako główne urządzenie dostępu
Smartfony skondensowały w jednym urządzeniu funkcje telefonu, aparatu, odtwarzacza muzyki, przeglądarki i konsoli wideo. Z perspektywy Internetu oznaczało to, że:
- czas spędzany online rozłożył się na wiele krótkich sesji w ciągu dnia,
- treści musiały być projektowane w formacie przyjaznym małym ekranom i przerwom w uwadze (pionowe wideo, krótkie klipy),
- wzrosło znaczenie aplikacji natywnych, które integrowały komunikację, media i płatności w jednym interfejsie.
Streaming wideo trafił do transportu publicznego, kolejek w sklepie, przerw w pracy. Serwisy dostosowały się, wprowadzając funkcje takie jak automatyczne buforowanie odcinków w sieciach Wi-Fi, aby ograniczyć zużycie pakietów danych, czy możliwość pobierania treści do trybu offline. Z perspektywy operatorów komórkowych oznaczało to konieczność rozbudowy pojemności sieci i wprowadzenia nowych planów taryfowych (np. pakiety „bez limitu” dla wybranych serwisów streamingowych).
Sieci 4G/5G i usługi w czasie rzeczywistym
Rozwój 4G, a następnie 5G, otworzył drogę do usług, które wymagają niskich opóźnień i stabilnego transferu: transmisji na żywo w wysokiej rozdzielczości, gier w chmurze, czy zdalnych wydarzeń z elementami rozszerzonej rzeczywistości. Technicznie 5G wprowadziło mechanizmy takie jak network slicing – możliwość wydzielenia w ramach tej samej infrastruktury logicznych segmentów o gwarantowanych parametrach jakościowych.
Dla dostawców treści oznaczało to szansę na świadome różnicowanie usług. Można było oferować „premium streaming” z gwarantowaną jakością transmisji meczów czy koncertów, oparty o specjalne umowy z operatorami sieci komórkowych. Z kolei z punktu widzenia neutralności sieci i konkurencji rodziło to pytania o równość dostępu mniejszych podmiotów do podobnych parametrów technicznych.
Web 2.0 i przejście od stron do platform
Równolegle do zmian w infrastrukturze zachodziła ewolucja w warstwie aplikacyjnej. Pojęcie Web 2.0 opisywało przejście od statycznych stron i prostych formularzy do usług, w których użytkownicy stali się współtwórcami treści, a interfejsy zaczęły przypominać aplikacje desktopowe.
Techniczne fundamenty interaktywności
Przejście do Web 2.0 umożliwiło połączenie kilku technologii: AJAX-u (asynchroniczne zapytania do serwera bez przeładowywania całej strony), rozbudowanych bibliotek JavaScript, arkuszy stylów CSS i baz danych zdolnych do obsługi tysięcy jednoczesnych zapytań. Zamiast sekwencji osobnych stron użytkownik miał wrażenie pracy w jednej, dynamicznej aplikacji.
Z perspektywy projektowania usług różnica była zasadnicza. Można było:
- płynnie aktualizować fragmenty interfejsu w odpowiedzi na działania użytkownika,
- wprowadzać ciągłe przewijanie, podpowiedzi w wyszukiwarkach, edycję treści „na żywo”,
- wbudować w te same narzędzia funkcje komunikacji (komentarze, wiadomości, czaty grupowe).
Powstały w ten sposób „platformy” – środowiska, w których użytkownik nie tylko konsumował treści, ale też je tworzył i dystrybuował. Blogi, wiki, serwisy do współdzielenia zdjęć czy repozytoria kodu zaczęły pełnić rolę cyfrowych przestrzeni roboczych i miejsc spotkań społeczności.
Od blogów i forów do wielkich platform społecznościowych
Pierwsze narzędzia Web 2.0 – blogi, fora, wiki – były stosunkowo rozproszone. Użytkownik zakładał własnego bloga, konto na forum konkretnej społeczności czy współtworzył jedno wybrane wiki. Z czasem pojawiły się jednak usługi, które zaczęły integrować wiele funkcji naraz: publikowanie treści, system znajomych, prywatne wiadomości, wydarzenia, grupy tematyczne. Zamiast dziesiątek małych wysp powstały kilku‑, a potem kilkunastofunkcyjne „kontynenty” społecznościowe.
Mechanika tych serwisów opierała się na prostych, ale skutecznych zasadach. Każda aktywność – komentarz, polubienie, udostępnienie – generowała powiadomienie i bodziec do powrotu. Jeśli dana treść wzbudzała reakcje, algorytm promował ją w strumieniach innych osób, co zachęcało do dalszej aktywności. Dla użytkowników oznaczało to łatwiejszy kontakt ze znajomymi, dla twórców – dostęp do szerokiej publiczności bez konieczności samodzielnego budowania infrastruktury technicznej.
Kosztem tej wygody była jednak rosnąca centralizacja. To platforma decydowała, co trafia na górę strumienia, jakie formaty są preferowane, a nawet jakie typy linków są mniej eksponowane. Z punktu widzenia małego wydawcy czy organizacji społecznej oznaczało to, że jeśli algorytm zmieniał priorytety – na przykład faworyzując wideo kosztem wpisów tekstowych – cały wcześniejszy sposób komunikacji przestawał być skuteczny. Strategia obecności w sieci stała się w praktyce strategią obecności na kilku dominujących platformach.
Model biznesowy tych usług w coraz większym stopniu opierał się na gospodarce uwagi. Jeśli celem jest maksymalizacja czasu spędzanego w aplikacji, to projekt interfejsu, dobór powiadomień czy kształt rekomendacji są podporządkowane utrzymaniu użytkownika jak najdłużej. Mechanizmy znane z kasyn (nagrody o zmiennej częstotliwości, przewijanie bez końca, licznik „reakcji”) trafiły do głównego nurtu projektowania produktów cyfrowych. Granica między narzędziem komunikacji a środowiskiem do ciągłej konsumpcji bodźców coraz bardziej się zacierała.
Historia Internetu – od eksperymentu z komutacją pakietów w sieci badawczej po globalne platformy sterowane algorytmami – pokazuje, jak silnie decyzje techniczne splatają się z ekonomią i praktykami społecznymi. To, czy użytkownik widzi otwartą sieć różnorodnych usług, czy raczej kilka domyślnych aplikacji w telefonie, zależy już nie tylko od przepustowości łączy, lecz także od architektury protokołów, regulacji prawnych i dominujących modeli biznesowych.
Algorytmy rekomendacji i personalizacja na masową skalę
Gdy objętość treści przekroczyła możliwości prostego chronologicznego strumienia, ciężar zarządzania uwagą przesunął się na algorytmy rekomendacji. Zamiast pytać użytkownika, które profile chce śledzić, system zaczął przewidywać, co „powinien” zobaczyć na podstawie zachowań podobnych osób, historii kliknięć, czasu oglądania, a nawet sposobu przewijania ekranu.
Na poziomie technicznym kluczowe stały się modele uczenia maszynowego, które:
- klasyfikowały treści według tematu, formatu i potencjalnego „zaangażowania”,
- segmentowały użytkowników na grupy o podobnych zachowaniach,
- testowały różne konfiguracje strumienia (A/B testing) w skali milionów kont jednocześnie.
Decyzja, który post, film czy relacja pojawi się wyżej, przestała być prostą funkcją czasu publikacji. Zależała od prawdopodobieństwa reakcji, przewidywanego czasu spędzonego w aplikacji, a niekiedy również od oczekiwanych przychodów reklamowych. W efekcie dwóch użytkowników obserwujących ten sam zestaw kont mogło widzieć zupełnie różne „obrazy świata”.
Personalizacja zwiększyła komfort korzystania z serwisów: mniej przypadkowych treści, więcej materiałów rzeczywiście trafiających w zainteresowania. Jednocześnie utrudniła ocenę, czy dana platforma faworyzuje określone źródła informacji. Transparentność działania algorytmów stała się przedmiotem debat regulacyjnych, a pojęcia takie jak „bańka informacyjna” czy „komora pogłosowa” weszły do języka szerszej dyskusji publicznej.
Monetyzacja treści i nowe role w ekosystemie
Gdy platformy skupiły uwagę setek milionów użytkowników, kolejnym krokiem było uporządkowanie mechanizmów monetyzacji. Oprócz klasycznego modelu reklam graficznych pojawiły się rozwinięte programy partnerskie, mikropłatności, subskrypcje i sprzedaż produktów bezpośrednio z poziomu treści.
W tym układzie wyłoniły się trzy główne role:
- platforma – dostarcza infrastrukturę, algorytm dystrybucji i narzędzia analityczne,
- twórca – produkuje treści zgodnie z preferowanymi formatami i rytmem publikacji,
- reklamodawca lub sponsor – finansuje obecność poprzez kampanie targetowane lub współprace z twórcami.
Jeśli algorytm premiował częste publikacje krótkich materiałów wideo, twórcy dostosowywali proces produkcji do tego rytmu. Jeśli lepiej monetyzowały się transmisje na żywo z aktywnym czatem i „darowiznami” od widzów, rosło znaczenie formatu live. W ten sposób techniczne i biznesowe założenia platform zaczęły wpływać na strukturę samej kultury internetowej – od długości przeciętnego filmu po sposób kadrowania i styl narracji.
Wzrosło również znaczenie „pośredników drugiego rzędu”: sieci partnerskich (MCN), agencji reprezentujących twórców, firm specjalizujących się w optymalizacji treści pod kątem algorytmów (SEO/ASO, optymalizacja miniatur, testy tytułów). Dla wielu osób Internet z przestrzeni wymiany informacji stał się jednym z głównych rynków pracy, ale o warunkach na tym rynku w dużym stopniu decydowały zmienne, rzadko przejrzyście komunikowane reguły platform.
Synchronizacja mediów społecznościowych ze światem fizycznym
Kolejny etap ewolucji wiązał się z coraz głębszą integracją usług online z aktywnością offline. Smartfon z dostępem do Internetu stał się nie tylko ekranem, lecz także czujnikiem: lokalizacji, ruchu, dźwięku, obrazu. Media społecznościowe zaczęły wykorzystywać te dane do łączenia treści z kontekstem miejsca i czasu.
Typowe przykłady to:
- tagowanie lokalizacji w postach i relacjach, co pozwalało tworzyć „warstwę społeczną” nad mapą miasta,
- integracja z kalendarzami i systemami biletowymi – wydarzenia organizowane w sieci przenosiły się do fizycznych przestrzeni, a relacje z nich wracały na platformy,
- rekomendacje „popularne w okolicy” lub „modne teraz”, generowane w oparciu o lokalne wzorce zachowań użytkowników.
Przykładowa wizyta w restauracji stała się często równoległym doświadczeniem online: od sprawdzenia opinii i rezerwacji przez aplikację, przez udostępnienie zdjęcia potrawy w serwisie społecznościowym, po wystawienie oceny, która wpłynie na kolejne rekomendacje w tym samym mieście. Rzeczywistość cyfrowa i fizyczna przeniknęły się, a przepływ informacji między nimi stał się niemal automatyczny.
Gospodarka uwagi i zmiana modeli pracy w sieci
Im bardziej Internet przesuwał się w stronę platform społecznościowych i streamingu, tym wyraźniej widać było, że zasobem ograniczonym nie jest już przepustowość łącz, lecz czas i koncentracja użytkowników. Gospodarka uwagi przestała być metaforą, a stała się konkretnym zbiorem wskaźników w panelach analitycznych – średni czas sesji, współczynnik retencji, częstotliwość powrotów.
Metryki zaangażowania jako oś projektowania usług
Platformy zaczęły mierzyć niemal każdy aspekt zachowania użytkownika: ile sekund spędza nad konkretnym materiałem, które fragmenty przewija szybciej, kiedy najczęściej wychodzi z aplikacji. Na tej podstawie projektowano mechanizmy utrzymywania uwagi:
- autoodtwarzanie kolejnych filmów lub odcinków bez wyraźnej przerwy decyzyjnej,
- pasek „postępu serii” lub „celów dziennych”, bazujący na psychologii domykania zadań,
- powiadomienia o aktywności znajomych lub twórców, wyzwalane w momentach spadku aktywności użytkownika.
Dla serwisu streamingowego granicą odcinka przestał być impuls do wyłączenia urządzenia, a stał się momentem, w którym można zaproponować „jeszcze jeden” materiał. Dla aplikacji społecznościowej każda przerwa w aktywności była szansą na wysłanie przypomnienia lub sugestii nowej interakcji. Rywalizacja toczyła się nie tylko między firmami, ale też między różnymi typami treści w obrębie tego samego ekosystemu: krótkie wideo konkurowało z dłuższymi formami, relacje „na żywo” z zapisanymi transmisjami.
Praca kreatywna pod dyktando algorytmów
W miarę jak coraz więcej zawodów kreatywnych przenosiło się do sieci, narzędzia analityczne i rekomendacyjne zaczęły wpływać na codzienną praktykę pracy. Twórca treści, dziennikarz, trener czy nauczyciel prowadzący zajęcia online widział w panelu statystyk precyzyjne informacje o odpływach uwagi, kliknięciach w reklamę i segmentach odbiorców.
Jeśli celem było utrzymanie przychodów z reklam lub subskrypcji, to presja na optymalizację pod algorytmy stawała się bardzo konkretna. Decyzje o długości materiału, częstotliwości publikacji, a nawet doborze tematów i tytułów były podejmowane nie tylko z perspektywy merytorycznej, lecz także pod kątem spodziewanej „klikalności”. W wielu branżach doszło do rozwarstwienia: obok niewielkiej grupy bardzo dużych podmiotów z profesjonalnymi zespołami analitycznymi funkcjonowały tysiące drobnych twórców, dla których zmiana algorytmu mogła oznaczać nagły spadek dochodów.
To zjawisko było szczególnie widoczne na styku social mediów i streamingu na żywo. Model „pracuję, gdy świeci się czerwona lampka i licznik widzów rośnie” zależał bezpośrednio od tego, jak często platforma promuje danego twórcę w sekcji „polecane” lub „na topie”. Praca twórcza zaczęła przypominać wolny zawód uzależniony od nieprzewidywalnego połączenia gustów odbiorców i decyzji algorytmów.
Od otwartych standardów do zamkniętych ekosystemów
Początkowa faza rozwoju Internetu opierała się głównie na otwartych protokołach i neutralności infrastruktury. Wraz z rozwojem aplikacji mobilnych i platform społecznościowych ciężar innowacji przesunął się w stronę zamkniętych ekosystemów kontrolowanych przez kilka podmiotów. Zmieniło to architekturę zarówno techniczną, jak i ekonomiczną sieci.
Platformy mobilne jako nowi „dozorcy” dostępu
Wejście smartfonów na rynek wprowadziło dodatkową warstwę pośredniczącą między użytkownikiem a Internetem: system operacyjny z własnym sklepem aplikacji. To on decydował, które aplikacje są dostępne, jakie mają uprawnienia, w jaki sposób mogą się komunikować z innymi usługami, a nawet jaki model subskrypcji jest dopuszczalny.
Dla twórców serwisów streamingowych i społecznościowych oznaczało to konieczność podporządkowania się regułom dystrybucji aplikacji (opłaty prowizyjne, zasady dotyczące płatności wewnątrz aplikacji, wymogi prywatności). W wielu przypadkach kluczowe stało się znalezienie równowagi między aplikacją natywną a wersją webową, uruchamianą w przeglądarce mobilnej, która nadal opierała się na otwartych standardach.
Z perspektywy użytkownika wygoda centralnego sklepu i spójnych zasad bezpieczeństwa była oczywista. Z perspektywy rozwoju sieci pojawiły się jednak nowe punkty koncentracji władzy: operator platformy mógł w praktyce zablokować lub utrudnić działanie całych kategorii usług, ograniczając konkurencję lub negocjując korzystniejsze warunki finansowe.
API, integracje i zależności między platformami
Drugim wymiarem zamykania ekosystemów była kontrola nad interfejsami programistycznymi (API). W początkowym okresie Web 2.0 otwarte API umożliwiały tworzenie klientów zewnętrznych, agregatorów treści, narzędzi analitycznych czy aplikacji łączących dane z wielu źródeł. Z czasem część platform ograniczyła lub skomercjalizowała dostęp do tych interfejsów.
Typowy schemat wyglądał następująco: najpierw bardzo otwarty dostęp w celu szybkiego zbudowania ekosystemu, później stopniowe zaostrzenie warunków – limity zapytań, wymóg rejestracji aplikacji, opłaty dla podmiotów biznesowych. Uzasadniano to kwestiami bezpieczeństwa i nadużyć, ale jednocześnie pozwalało to lepiej kontrolować, kto i na jakich zasadach może „wyciągać” wartość z danych gromadzonych przez platformę.
Konsekwencją była rosnąca liczba „murów” między usługami. Dane użytkowników – listy znajomych, historię aktywności, preferencje – coraz trudniej było przenosić między serwisami. Zamiast jednego, względnie spójnego Internetu, użytkownik doświadczał zestawu pół-zamkniętych środowisk, w których możliwość interakcji zależała od ustaleń między firmami i obowiązujących regulaminów API.
Streaming na żywo, gry i wspólne doświadczenia online
O ile pierwsza fala streamingu dotyczyła głównie treści na żądanie, o tyle kolejnym krokiem była eksplozja usług live. Transmisje na żywo połączyły infrastrukturę wideo z mechanizmami interakcji znanymi z mediów społecznościowych, tworząc nową kategorię doświadczeń w sieci.
Od broadcastu do współuczestnictwa
Transmisja sportowa czy koncertowa w klasycznym modelu przypominała telewizję – jednokierunkowy przekaz z centrum do odbiorców. W wersji internetowej pojawiły się elementy współuczestnictwa: czat na żywo, głosowania, reakcje pojawiające się w czasie rzeczywistym na ekranie.
W praktyce oznaczało to, że:
- oglądający stawali się widoczną częścią wydarzenia, wpływając na jego przebieg (np. wybór utworu na bis, pytania w trakcie panelu),
- twórca lub organizator mógł eksperymentować z modelem wynagradzania – bilety cyfrowe, napiwki, ekskluzywny dostęp do zakulisowych materiałów,
- wspólne oglądanie (watch party) łączyło streaming treści z prywatnymi przestrzeniami komunikacji, takimi jak czaty grupowe czy serwery głosowe.
Szczególne znaczenie miało to w świecie gier. Serwisy dedykowane transmisjom rozgrywek połączyły trzy elementy: techniczny streaming wideo o niskim opóźnieniu, społeczności gromadzące się wokół konkretnych tytułów oraz możliwość natychmiastowego wsparcia finansowego twórcy. Gra przestała być wyłącznie prywatną aktywnością, a stała się widowiskiem, w którym rola widowni jest równie istotna jak umiejętności gracza.
E-sport, wydarzenia hybrydowe i globalna publiczność
Rozwój streamingu na żywo umożliwił także powstanie nowych formatów wydarzeń o skali porównywalnej z tradycyjnymi widowiskami sportowymi. Turnieje e-sportowe, konferencje technologiczne czy koncerty online stały się wydarzeniami planowanymi z myślą o publiczności rozproszonej na wielu kontynentach.
Technicznie wymagało to:
- infrastruktury CDN zdolnej do obsługi setek tysięcy równoczesnych widzów przy minimalnym opóźnieniu,
- mechanizmów adaptacyjnego bitrate’u, które dostosowywały jakość obrazu do bieżących warunków łącza użytkownika,
- narzędzi moderacji i filtrowania treści na czatach w czasie rzeczywistym.
Od strony organizacyjnej pojawiły się formaty hybrydowe – niewielka liczba uczestników na miejscu i duża publiczność online. Wymusiło to inne podejście do scenografii, realizacji obrazu, planowania interakcji z widownią. Granica między „oglądaniem telewizji” a „uczestniczeniem w wydarzeniu” stała się mniej wyraźna, a streaming live stał się pełnoprawnym medium, a nie tylko dodatkiem do tradycyjnej transmisji.
Streaming gier i e-sportu pokazały też, jak silnie infrastruktura sieciowa wpływa na kształt samej rozrywki. Jeśli liczy się opóźnienie liczona w milisekundach, to wybór serwera, odległość od węzła operatora, a nawet pora dnia mogą decydować o wyniku meczu i jakości widowiska. Organizatorzy dużych turniejów zaczęli więc współpracować bezpośrednio z dostawcami sieci i chmur obliczeniowych, projektując architekturę wydarzenia od warstwy kabli i centrów danych po aplikację czatu na ekranie widza.
Wspólne doświadczenia online wykraczają jednak poza gry. Platformy do współoglądania filmów, narzędzia współpracy z funkcją „udzielania kontroli” nad ekranem, koncerty realizowane jednocześnie w VR i w klasycznym streamie – wszystko to korzysta z podobnego zestawu technologii: przesyłania obrazu na żywo, synchronizacji wielu strumieni oraz kanałów interakcji w czasie rzeczywistym. W efekcie rozrywka, praca i edukacja zaczęły korzystać z tej samej infrastruktury, różniąc się głównie interfejsem i modelem biznesowym.
Rosnąca złożoność tych usług sprawiła, że użytkownik coraz rzadziej obcuje z „gołym” Internetem, a częściej z konkretnymi środowiskami – grą, platformą streamingową, systemem konferencyjnym. To one definiują zasady widoczności, dostępności i własności treści tworzonych podczas wydarzenia. Nagrania streamów, czaty, klipy wycięte przez widzów czy modyfikacje gier żyją w obrębie danego ekosystemu i tylko częściowo w otwartej sieci.
Historia Internetu od ARPANET-u po erę social mediów i streamingu układa się w opowieść o tym, jak otwarta infrastruktura badawcza stała się kręgosłupem codziennego życia – od komunikacji i pracy, przez rozrywkę, po politykę i gospodarkę. Kolejne warstwy – protokoły, przeglądarki, wyszukiwarki, platformy społecznościowe, mobilne systemy operacyjne – nadbudowywały się nad sobą, przenosząc punkt ciężkości z otwartych standardów na zamknięte środowiska i z techniki na ekonomię uwagi. Od tego, jakie decyzje regulacyjne, biznesowe i techniczne będą podejmowane w najbliższych latach, zależy, czy sieć pozostanie przede wszystkim wspólną infrastrukturą komunikacji, czy raczej zbiorem kilku dominujących ekosystemów kontrolujących dostęp do globalnej publiczności.